Cross-Lingual Transfer
여러 언어를 한 모델로 학습하면 저자원 언어가 다른 언어에서 배운 표현을 활용할 수 있다. 예를 들어 해당 언어만으로는 학습할 text가 부족하더라도, 공유 model과 subword space를 통해 고자원 언어에서 학습한 정보가 전달될 수 있다. 이것이 positive transfer다. 그러나 model의 capacity가 고정되어 있다면 언어 수를 늘릴수록 각 언어가 그 자원을 나누어 써야 하므로, 언어 추가가 항상 성능 향상으로 이어지는 것은 아니다.
Positive Transfer and Capacity Dilution
XLM-R은 100개 언어의 2.5TB CommonCrawl로 학습한 모델이며, 270M/550M parameters와 250K Vocabulary를 사용한다. 강의의 XNLI ablation에서는 언어 수를 7개에서 15개로 늘릴 때 positive transfer가 나타나지만, 100개로 늘리면 capacity dilution이 나타난다. 71.8/67.7 같은 결과는 이처럼 language 수와 model 조건이 정해진 비교의 값이다.
문제는 “언어가 많으면 좋다”와 “언어가 많으면 나쁘다” 중 하나를 고르는 것이 아니다. 공유로 얻는 이익과 제한된 capacity에서의 경쟁이 동시에 존재한다. Larger model, larger Vocabulary, language sampling은 이 균형을 조정하는 축이다. Sampling을 바꾸면 언어별 training data 양의 차이가 학습에 얼마나 반영될지도 달라진다.
Multilingual and Cross-Lingual
Multilingual은 여러 언어를 다룬다는 뜻이고, Cross-lingual은 한 언어에서 얻은 지식이나 표현이 다른 언어에 연결되는 것을 가리킨다. 여러 언어의 text를 사용했다는 사실만으로 어떤 transfer mechanism을 썼는지가 정해지지는 않는다.
XLM의 Translation Language Modeling(TLM)은 parallel sentence pair를 함께 놓고 일부 token을 가린다. 한 언어의 빈칸을 복원할 때 대응하는 다른 언어의 문장도 참고할 수 있으므로, 두 언어의 관계를 학습 신호에 직접 넣는다. 반면 XLM-R은 MLM 중심의 recipe를 큰 multilingual corpus에 적용한다. Parallel pair를 활용하는 objective와, 여러 언어의 monolingual data를 함께 학습하는 recipe를 구분해야 한다.
Bilingual Priming
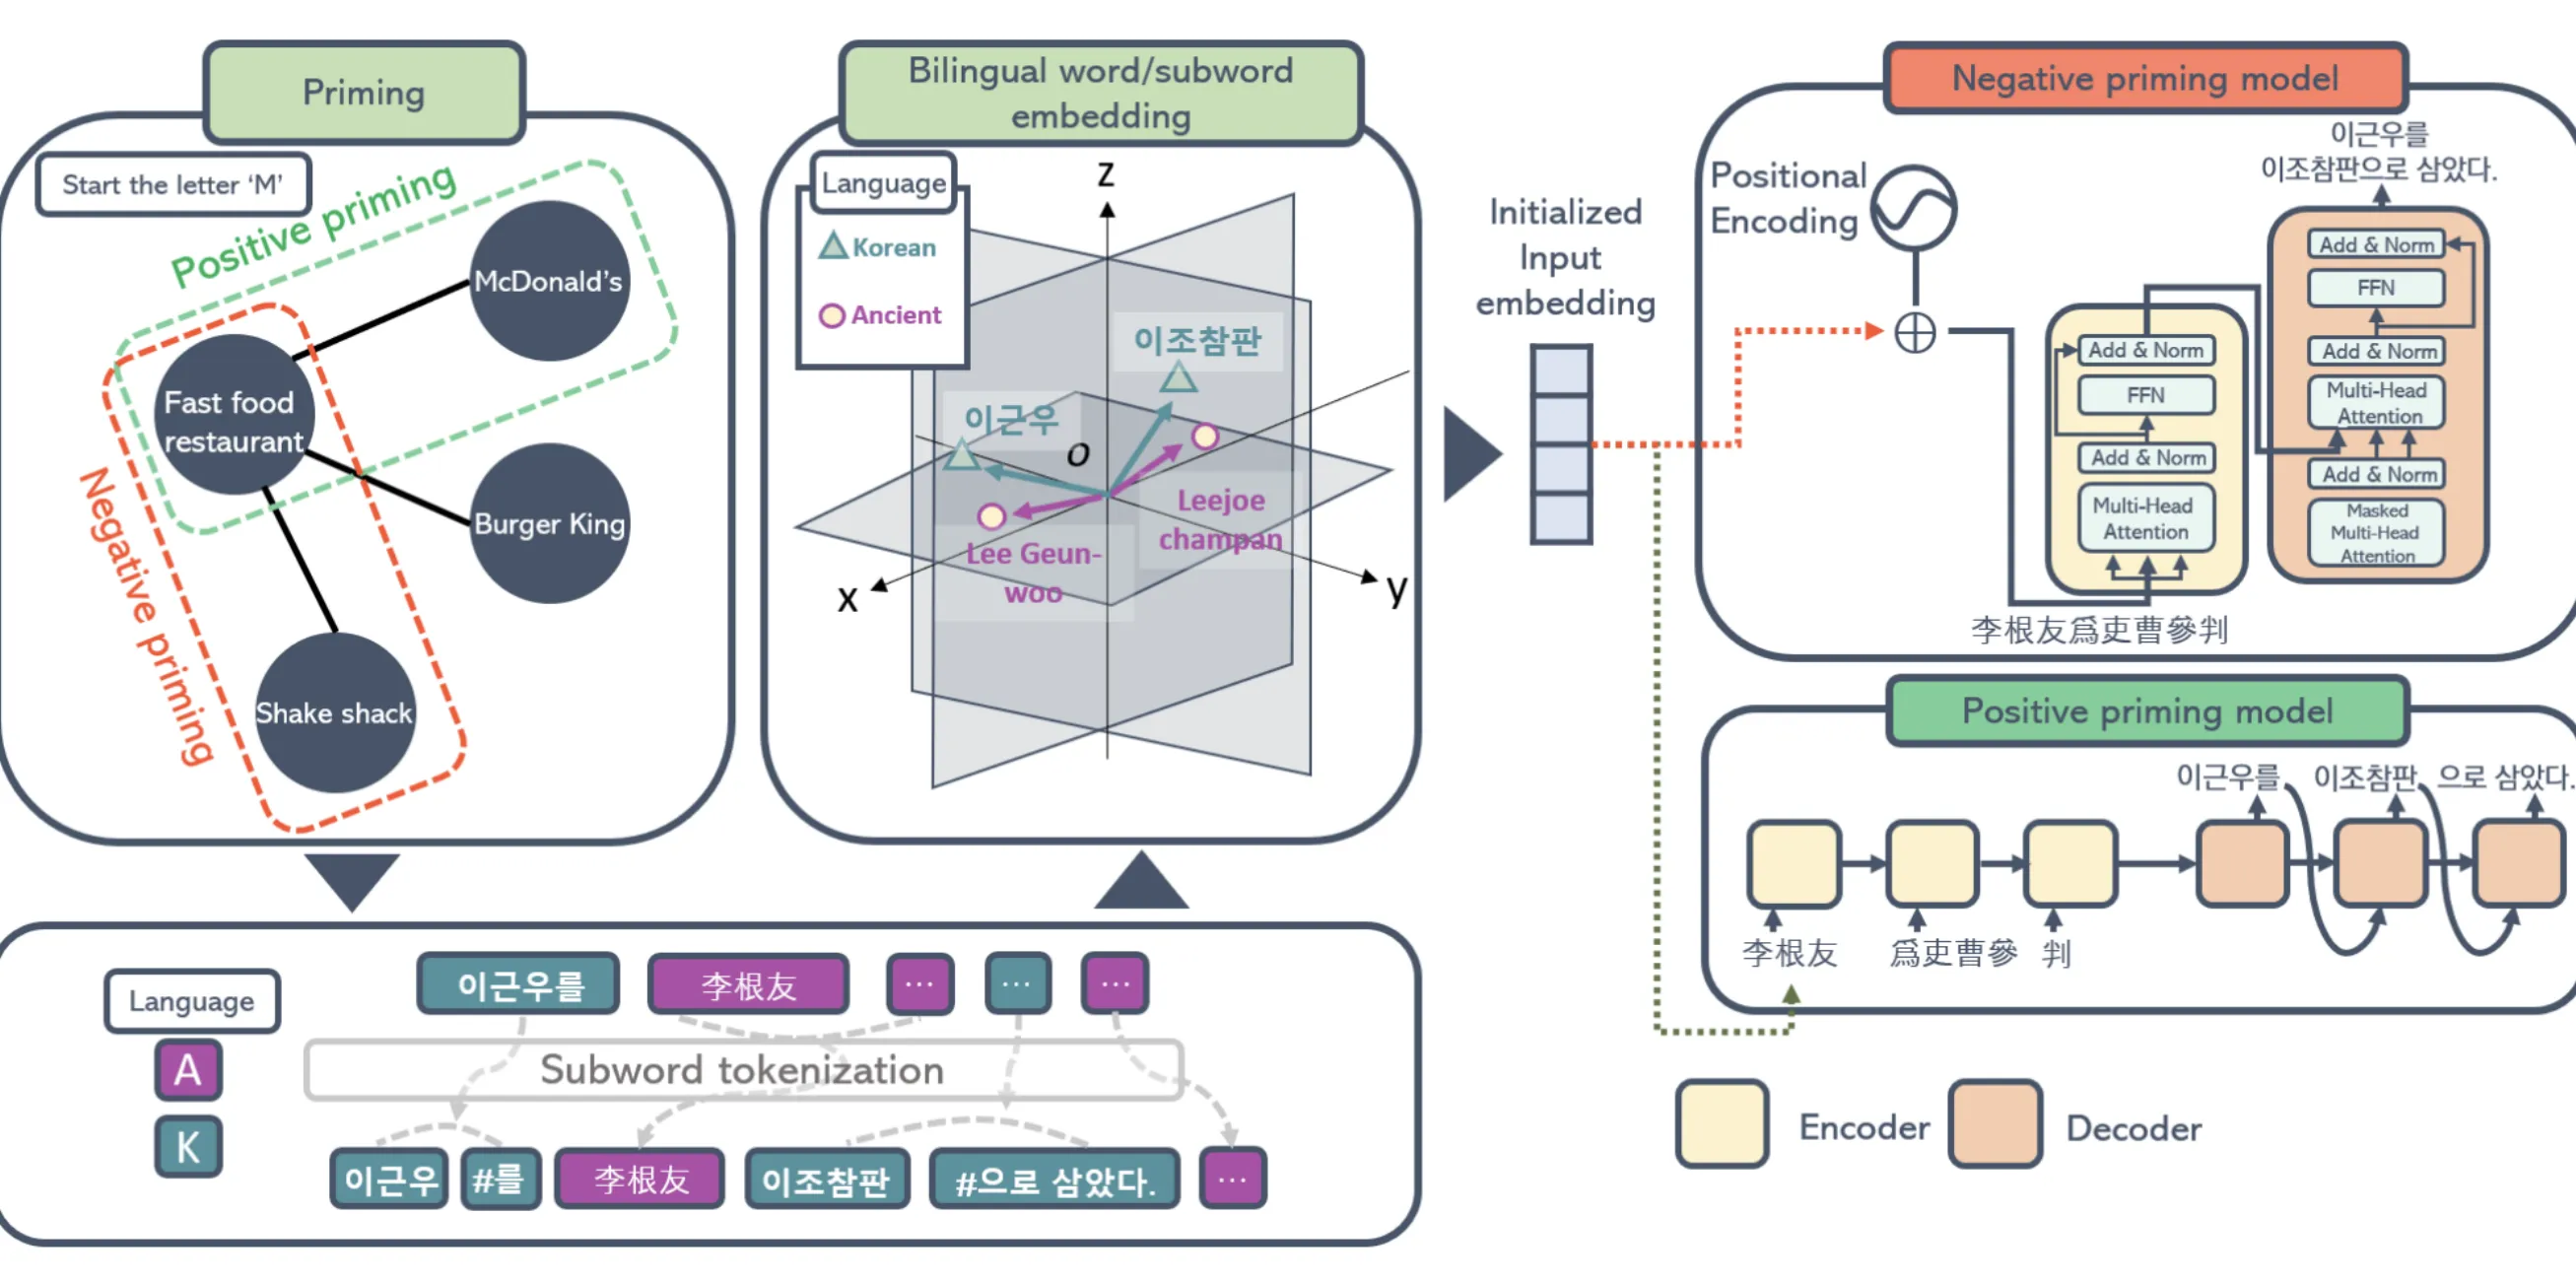
Ancient Korean NMT 사례에서는 현대 한국어와 고문서 사이의 bilingual word/subword space를 먼저 만들고, 이를 번역 모델의 초기 Embedding으로 옮긴다. 여기서 priming은 번역을 시작하기 전에 두 언어의 관련성을 담은 출발점을 제공하는 것이다. 고자원·저자원이라는 구분도 절대적인 언어 등급이 아니라, 현대 한국어와 해당 고문서 번역 자료 사이의 상대적인 학습 자원 차이다.
강의 figure는 Positional Encoding을 포함했을 때의 negative priming과, 이를 제거한 positive priming을 대비한다. 교수님이 강조한 것은 이 연구에서 언어 사이의 word/subword 관련성을 전달하는 일이 어순의 position을 함께 전달하는 것보다 유용했다는 점이다. 초기 Embedding을 무엇으로 채우는가와, 그 학습에 어떤 position 정보를 포함하는가는 별개의 선택이다. 이 결과를 모든 Translation model에서 position을 제거해야 한다거나 NoPE가 항상 우수하다는 주장으로 확대하지 않는다.
Check
언어 수를 늘릴 때 Positive transfer와 Capacity dilution이 어떻게 함께 나타나는가?
Answer
공유 구조는 저자원 언어를 돕지만 fixed capacity에 많은 언어를 담으면 언어별 표현 자원이 경쟁한다. Model/vocab/sampling 조건에 따라 균형이 달라진다.
Bilingual Priming
Ancient Korean Priming의 Positional Encoding 제거를 NoPE의 일반 우월성으로 해석할 수 없는 이유는?
Answer
특정 고문서 번역과 bilingual transfer setting이다. 목적·architecture가 다른 모든 task의 position 선택으로 일반화하지 않는다.