ALiBi · NoPE · Hybrid Attention
Position information을 주는 방법은 vector를 더하거나 회전하는 것만이 아니다. Score에 distance penalty를 줄 수도 있고, Causal Mask와 BOS가 이미 만드는 위치별 차이를 활용할 수도 있다. 또 위치를 어떻게 표현할지와 어디까지 Attention을 허용할지는 서로 다른 설계 선택이므로, 한 모델의 layers에서 다른 조합을 사용할 수 있다.
- Distance bias / Causal prefix signal / QK rotation
- layer별 position 설계
- local / full span 선택
ALiBi
ALiBi는 Softmax 전에 query-key distance에 비례한 linear penalty를 더한다. Head마다 fixed slope가 다르고 현재 위치는 penalty0이다. m이면 distance0/8/32에서 0/−1/−4다.
ALiBi에서는 content score에 를 더한다. 같은 content score라면 멀리 있는 Key가 더 큰 penalty를 받으므로 가까운 정보를 선호하는 bias가 된다. 현재 position은 distance 0이라 penalty도 0이고, 이면 distances 0/8/32의 penalties는 0/-1/-4다. Head마다 고정 slope를 다르게 쓴다.
이 ramp 자체가 position signal이므로 별도 position table이 필요 없다. 미관측 distance에도 식은 정의되지만, 그 사실이 긴 거리에서 정답을 찾는 품질까지 보장하지 않는다. 원 논문의 1.3B model, training 1K → evaluation 2K 결과는 해당 setting의 관찰이며, perplexity와 실제 long-context task 성능도 나누어 보아야 한다.
NoPE
NoPE의 “없다”는 것은 explicit position encoding을 넣지 않는다는 뜻이다. Causal prefix에서는 position이 뒤로 갈수록 읽을 수 있는 tokens가 늘어나므로 계산 구조 자체가 position에 따라 달라진다. BOS처럼 시작을 표시하는 anchor도 모든 위치에서 같은 비중으로 보이지 않는다.
Uniform Attention을 가정하면 첫 position의 BOS share는 1, 둘째는 1/2, 셋째는 1/3, 넷째는 1/4다. 같은 BOS라도 보이는 prefix 길이에 따라 contribution이 달라지므로 position-dependent information을 줄 수 있다. 실제 weights가 언제나 uniform이거나 model이 정확히 1/t만 계산한다는 주장이 아니라, 명시적 position vector 없이도 위치 단서가 생길 수 있음을 보여 주는 예시다.
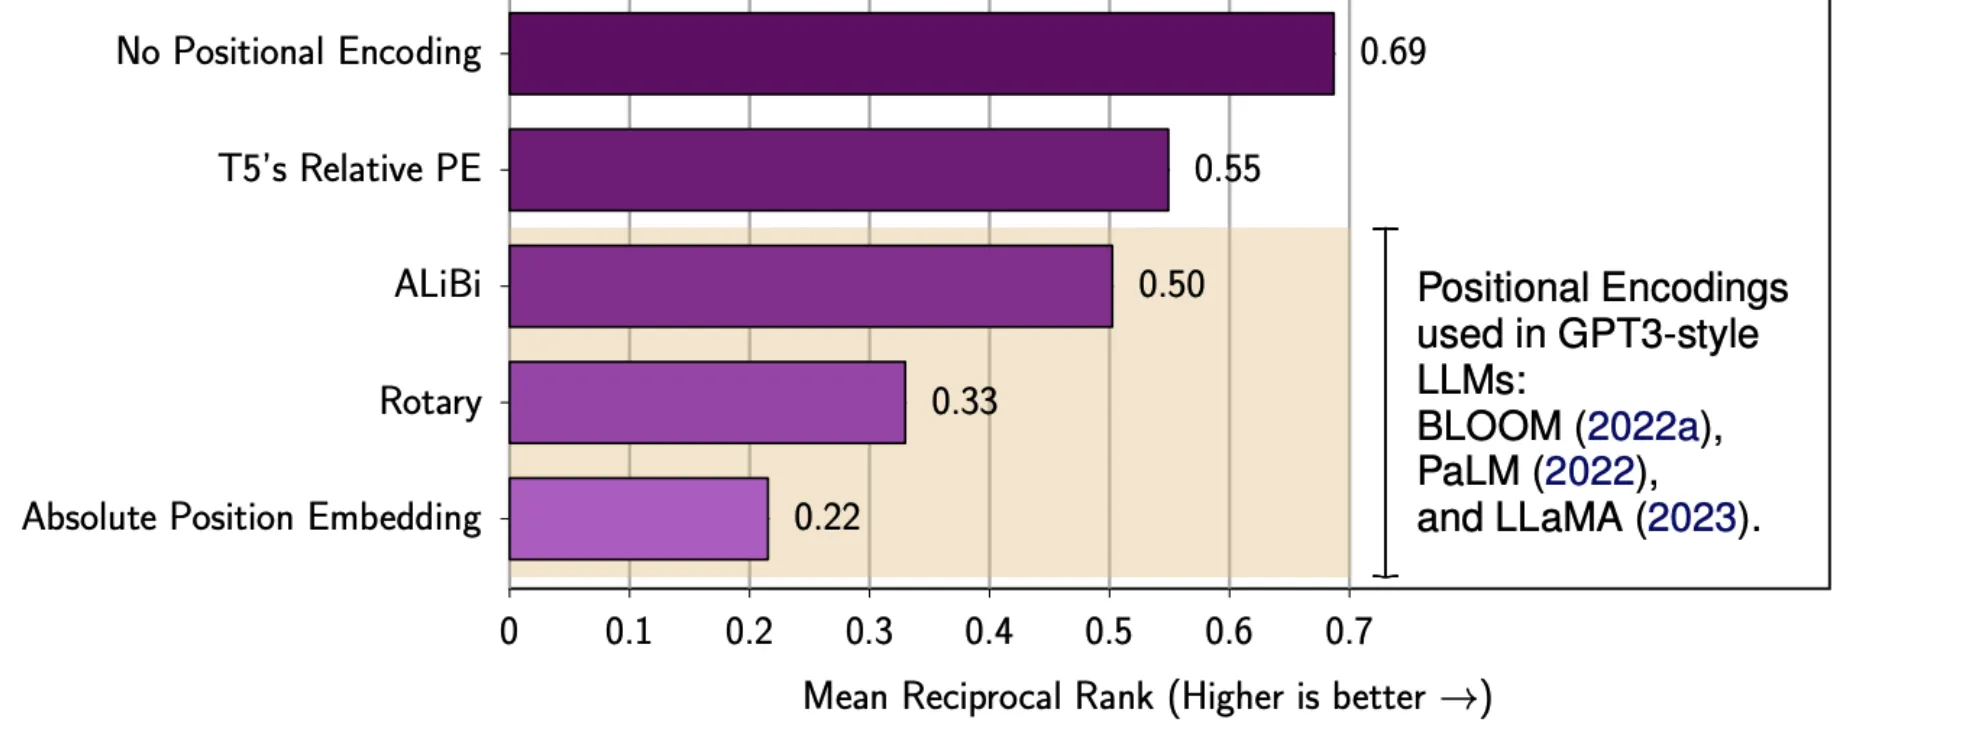
슬라이드의 reported result에서는 NoPE가 높은 Mean Reciprocal Rank를 보이고 task별 순위는 달랐다. 이를 모든 task에서 NoPE가 우수하다는 법칙으로 확대하지 않는다. Explicit encoding이 이 setting에서 필수는 아니라는 결론과 실제 model card에서 채택했다는 관찰을 구분한다.
Hybrid Attention
RoPE/NoPE layers는 한 model에서 interleave할 수 있다. Command 의 3localRoPE+1globalNoPE, SmolLM3의 every-fourthNoPE가 강의 예시다. Llama4Scout는 보고와 released config 차이가 있었음을 함께 적었다.
Command A의 예시에서는 local RoPE layers 3개와 global NoPE layer 1개를 반복한다. 여기서 local/full은 보게 하는 positions의 범위이고, RoPE/NoPE는 위치 신호의 방식이다. 이 조합을 선택한 이유가 있더라도 NoPE가 곧 full Attention의 정의가 되거나 RoPE가 항상 local이어야 하는 것은 아니다.
SmolLM3의 every-fourth NoPE도 한 stack에서 position 방식을 섞을 수 있음을 보여 준다. Llama 4 Scout는 보고와 released config의 차이가 있었다는 강의의 단서를 유지한다. 모델 이름으로 고정된 공식처럼 외우기보다 실제 layer pattern과 configuration을 읽어야 한다.
수업 설명의 RoPE/NoPE 명칭이 일부 뒤섞여 읽힌 부분이 있다. Local RoPE/global NoPE 예시와 position 방식·Attention span이 독립적인 설계라는 설명을 구분한다.
NoPE도 causal prefix/BOS의 implicit position signal을 활용할 수 있다.
Sinusoidal · RoPE · ALiBi · NoPE
Position signal을 넣는 위치와 방식이 다르다.
| Aspect | Sinusoidal | RoPE | ALiBi | NoPE |
|---|---|---|---|---|
| 적용 | Embedding에 vector 더함 | / 2D pairs 회전 | Score에 distance penalty | Explicit encoding 없음 |
| 신호 | 여러 sin/cos frequencies | Dot product의 relative rotation | Head별 fixed slope | Causal prefix / BOS anchor |
| 영향 | 입력 state에 더함 | 는 회전하지 않음 | 를 직접 바꾸지 않음 | Implicit signal 활용 |
| 긴 길이 | 계산 가능 ≠ 품질 보장 | Joint phase OOD 가능 | 정의 가능 ≠ 품질 보장 | Setting별 평가 필요 |
Positional encoding과 local/global Attention span은 독립적인 설계 축이다.
Check
NoPE에 position signal이 전혀 없다는 설명은 왜 잘못인가?
Answer
Explicit encoding은 없지만 causal prefix visibility와 BOS anchor가 위치 의존 정보를 제공할 수 있다.
Hybrid의 local RoPE/global NoPE 예시를 필수 결합으로 읽으면 안 되는 이유는?
Answer
Position encoding과 Attention span은 서로 다른 설계 축이다. 한 model에서도 layer별로 다른 조합을 사용할 수 있다.
NoPE의 BOS 1/t 예시가 position 정보가 전혀 없다는 해석과 다른 이유는?
Answer
Explicit position vector를 넣지 않아도 causal prefix의 크기가 position마다 달라진다. Uniform Attention 가정에서 BOS의 비중이 1/t가 되어 위치에 의존하는 단서가 된다. 이 예시와 특정 benchmark의 좋은 결과를 모든 task의 NoPE 우월성으로 일반화하지 않는다.
Explicit positional encoding 없이 causal prefix와 BOS anchor 같은 암묵적 위치 신호를 활용하는 선택은?
Answer
No Position Encoding (NoPE). 위치 신호가 모든 경로에서 사라진다는 뜻은 아니다.