Architecture & Objective
Encoder-only, Encoder-decoder, Decoder-only는 같은 Transformer 계열이지만, pre-training에서 어떤 token을 볼 수 있고 무엇을 예측하는지가 다르다. 이 차이는 이후 task를 수행하는 방식과 연결된다. Decoder-only가 주류가 된 이유를 이해하려면 objective와 task의 적합성, scale, serving, 생태계 투자를 함께 보아야 한다. 현재 많이 쓰인다는 사실만으로 모든 task에서 본질적으로 우수하다고 결론 내릴 수는 없다.
Objective Shapes the Interface
Encoder-only의 MLM이나 RTD는 입력 전체를 참고하는 contextual representation을 학습한다. 이를 classification head, Retrieval, Reranking에 연결할 수 있다. Decoder-only의 causal next-token prediction은 앞의 text를 조건으로 이어질 token을 만드는 학습이므로, continuation·dialogue·prompting을 같은 생성 interface로 표현하기 쉽다. Encoder-decoder는 source를 읽은 뒤 source-conditioned sequence를 생성하여 Translation·Summarization·ASR 등에 연결된다. 이것은 대표적인 적합성이지, 다른 task를 수행할 수 없다는 제한은 아니다.
Adaptation 방식도 결과를 바꾼다. Encoder 위에 새 classifier를 붙이는 fine-tuning과, task를 빈칸을 채우는 prompt로 바꾸어 MLM 형식을 유지하는 prompt-based fine-tuning은 같은 조건이 아니다. 후자는 pre-training에서 익힌 prediction interface를 task에서도 활용한다. 어떤 architecture가 좋은가라는 질문에는 어떤 objective로 학습하고 어떤 방식으로 적응시켰는지가 함께 들어가야 한다.
What Controlled Comparisons Show
Wang et al. (2022)은 5B가 넘는 parameters와 168B가 넘는 training tokens의 비교에서 이 차이를 보여준다. Self-supervised pre-training 직후 zero-shot에서는 causal decoder+LM이 강했지만, multitask prompted fine-tuning 뒤에는 non-causal 구조+MLM이 강했다. Fine-tuning 조건을 바꾸자 가장 좋은 configuration도 달라진 것이다.
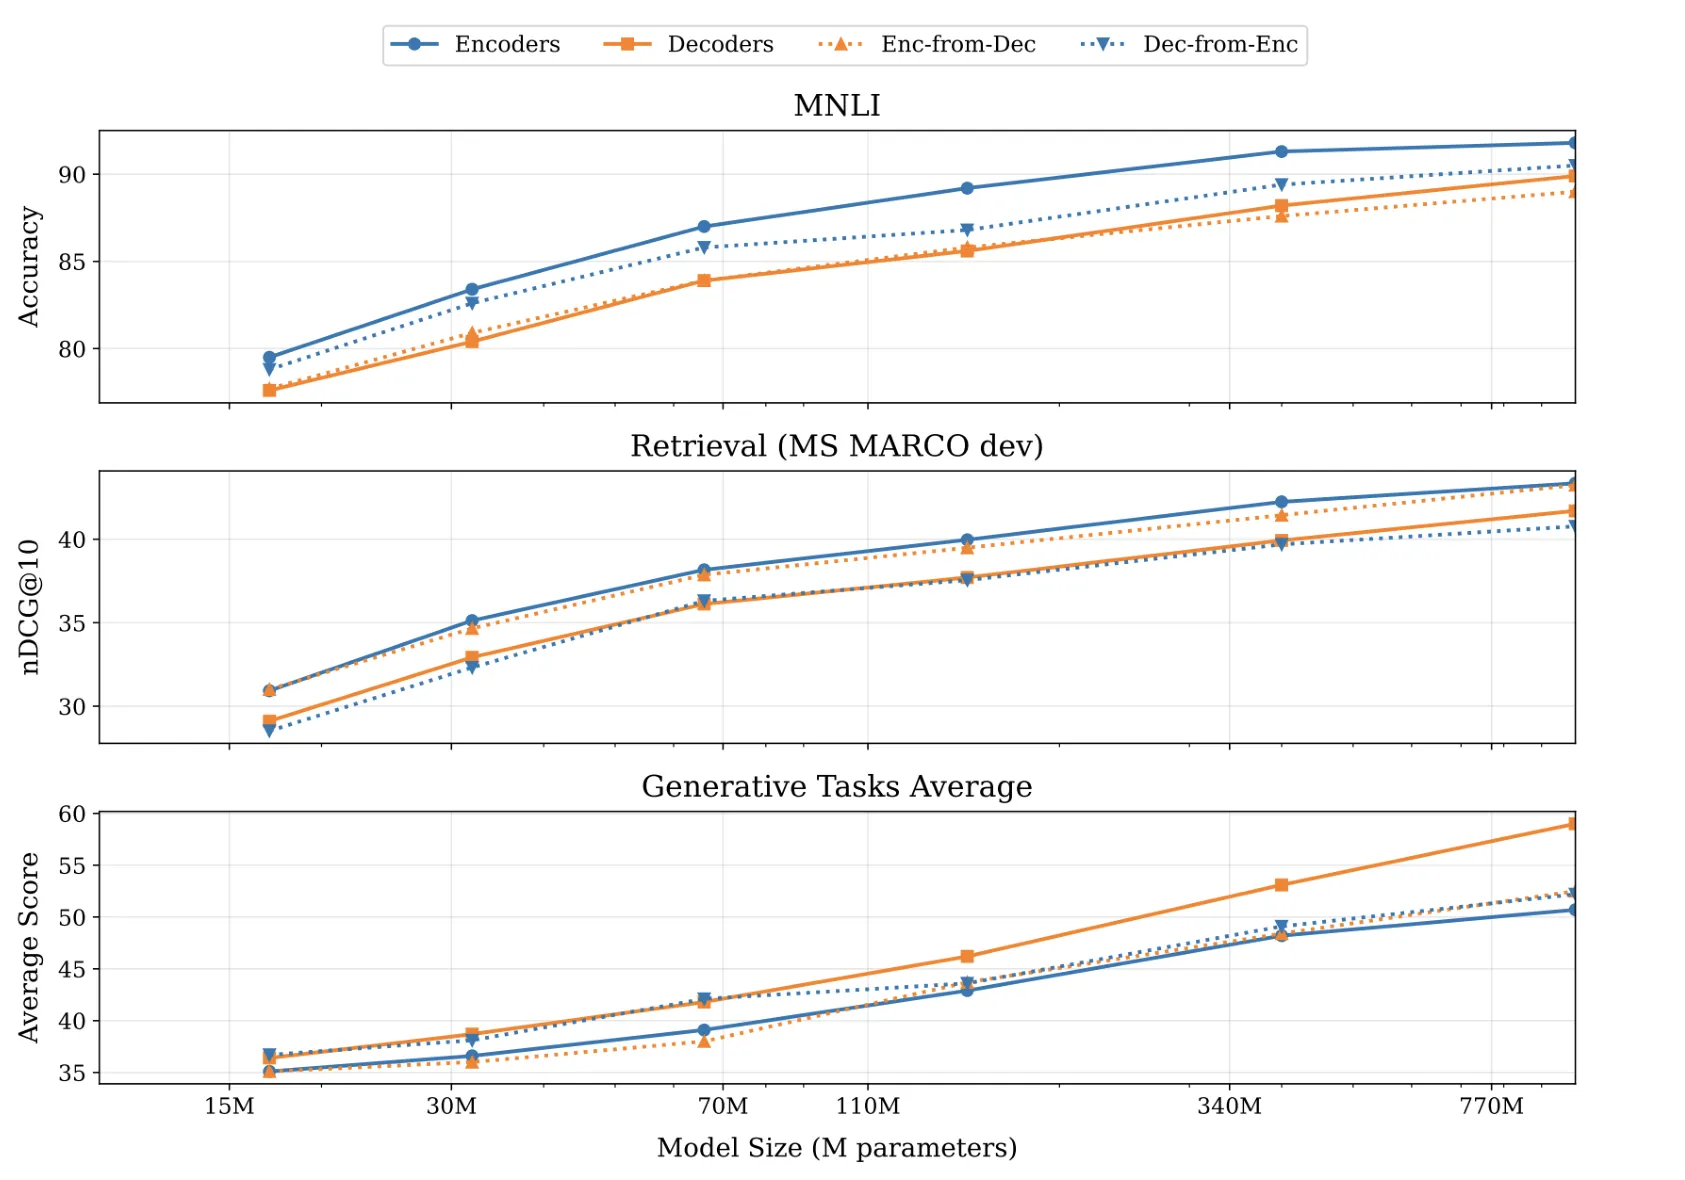
Ettin (2026)은 17M–1B 범위의 matched model 5쌍과 최대 2T training tokens를 비교한다. Encoders는 Classification·Retrieval에, Decoders는 Generation에 강했다. 다른 objective로 50B tokens를 추가 학습해도 기존 gap이 닫히지 않았다는 결과는 pre-training history가 이후 성능에 남는다는 근거다. 다만 이 실험을 objective 전환이 언제나 불가능하다는 법칙으로 읽어서는 안 된다.
Why Decoder-Only Became Dominant
Causal LM은 거의 모든 position에서 다음 token이라는 target을 얻는다. BERT의 일부 masked position만을 직접 맞히는 방식과 달리, text sequence 전체에 조밀한 next-token 학습 신호를 만들 수 있다. 또한 pre-training과 generation이 모두 “앞의 text에서 다음 token을 예측한다”는 형식을 공유한다. Instructions와 examples도 같은 context에 넣을 수 있어 task마다 별도 입력·출력 구조를 설계할 필요가 줄어든다.
하나의 causal stack으로 모델을 키우고 serving하는 방식이 정착한 뒤에는 data, API, kernel, tool에 대한 투자도 그 경로에 쌓였다. GPT-3 이후의 발전은 모델의 capability뿐 아니라 이런 system과 생태계의 축적을 함께 포함한다. 모든 task를 next-token format으로 표현할 수 있다는 말과, 그 format이 모든 task에서 최적이라는 말은 구분해야 한다.
KV Cache만으로 이 주류화를 설명할 수도 없다. Encoder-decoder에서도 decoder의 K/V를 cache할 수 있고, source는 한 번 encode하여 재사용할 수 있다. Cache는 generation 효율의 중요한 장치이지만 Decoder-only만의 독점적인 장점은 아니다.
Capability and Path Dependence
Bitter Lesson은 compute와 함께 scale되는 일반적인 방법이 역사적으로 강세를 보였다는 관점이다. 강의의 가설 A는 capability와 objective/task fit을, 가설 B는 path dependence와 인프라 투자를 강조한다. GPT-3의 scale 효과, Wang의 adaptation에 따른 결과 변화, Ettin의 task별 장점은 하나의 architecture 절대 우월설로 합쳐지지 않는다.
강의에 나온 picture/use theory 이미지는 언어를 바라보는 관점의 비유다. 이를 별도의 철학 이론으로 확대하기보다, 표현을 학습하는 역할과 실제 사용 맥락을 통해 task를 수행하는 역할의 차이를 생각하는 연결로 읽는다. Reinforcement Pre-Training 역시 next-token pre-training과 reasoning 학습의 관계를 묻는 recent extension으로 소개된 사례이며, 기존 recipe가 이미 대체되었다는 결론은 아니다.
PLM의 흐름은 Word vectors에서 pretrained backbone으로, GPT-1의 labeled fine-tuning에서 GPT-2의 zero-shot, GPT-3의 In-context Learning으로 이어진다. 이때 fine-tuning은 weights를 update하지만, In-context Learning은 test-time weights update 없이 context를 사용한다. Architecture의 이름만 외우기보다 objective·adaptation·task·system이 어떻게 연결되는지 설명할 수 있어야 한다.
Check
왜 Decoder-only가 강세가 되었는지 PLM 흐름·objective·system을 연결해서 서술하라.
Answer
Word vectors → pretrained backbone / 세 families → GPT-1 fine-tuning → GPT-2 zero-shot → GPT-3 ICL/scale로 interface가 바뀌었다. Causal pretraining과 generation/prompting의 일치, dense next-token 신호, stack/serving 단순성과 data/API/kernel 투자가 강세를 뒷받침했다. Encoder와 Encoder-decoder의 task 장점은 남는다.
Encoder-decoder도 KV Cache를 쓰는데 이를 Decoder-only 주류화의 유일한 이유로 들 수 없는 이유는?
Answer
Cache는 Encoder-decoder에도 있고 source는 한 번 encode할 수 있다. 강의는 objective/interface와 scaling/ecosystem의 여러 요인을 함께 제시한다.
Controlled comparison에서 fine-tuning 조건을 바꾸면 best architecture도 달라질 수 있는가?
Answer
그렇다. Wang의 pretrained zero-shot과 multitask prompted fine-tuning 뒤 결과가 달랐다. Ettin도 task별 Encoder/Decoder 장점이 달라 비교 조건을 유지해야 한다.
Decoder-only의 강세를 KV Cache 하나로 설명할 수 없는 이유는?
Answer
Encoder-decoder도 Decoder K/V를 cache하고 source를 한 번 encode하여 재사용할 수 있다. Causal pre-training과 prompting/generation의 일치, 조밀한 next-token targets, scale·serving·생태계 투자를 함께 보아야 한다. Task와 adaptation 조건에 따라 다른 architecture의 장점도 남는다.