MHA · GQA · MQA · MLA
앞의 KV Cache 계산에서 memory는 KV heads 수와 함께 커졌다. GQA/MQA는 Query heads를 유지하면서 그들이 참조할 K/V를 공유하고, MLA는 저장하는 K/V representation 자체를 압축한다. 출발점은 더 높은 benchmark score를 보장하는 것이 아니라 긴 context와 많은 요청에서 cache 비용을 줄이는 것이다. Quality, speed, memory는 따로 평가해야 한다.
- MHA full KV
- grouped/shared heads 또는 compressed latent
- smaller cache
- memory/quality/speed trade-off
Head Sharing
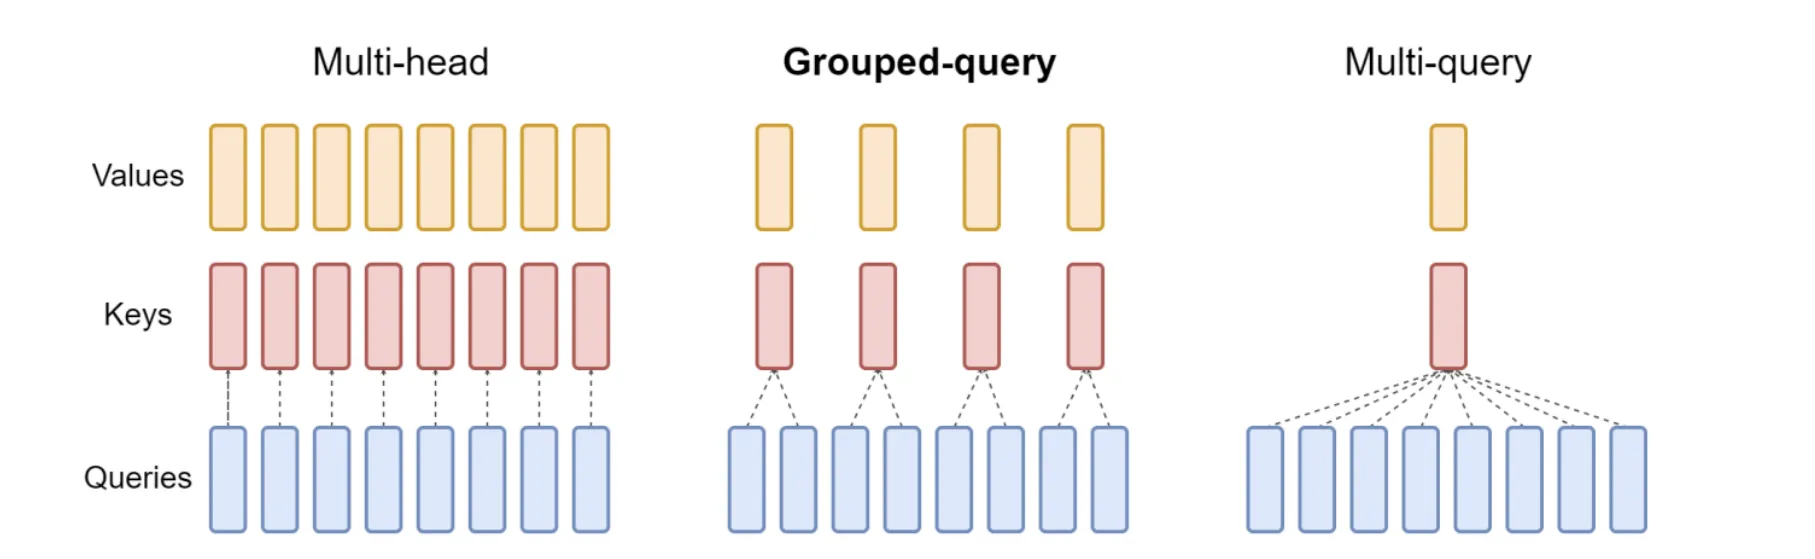
MHA는 Query head마다 KV head, MQA는 모든 Query가 1 KV head, GQA는 group별 KV 공유다. Multi-Head Latent Attention (MLA)은 full / 대신 compressed content latent와 decoupled RoPE key를 cache한다. 32 Query heads, width=128, BF16의 1 layer/1 token 예시는 MHA 16KiB, GQA-8 4KiB, MQA 512B, MLA 576 values≈1.1KiB다.
GQA
GQA 원 논문은 T5.1.1-XXL MHA checkpoint의 group별 / heads를 평균하고 original steps의 5%만큼 continued pre-training했다. GQA-8 평균 47.1 vs MHA 47.2, Decode 0.28s vs MQA 0.24s, MHA 1.51s는 해당 논문 setting이다. MHA quality와 MQA speed에 가까운 trade-off를 보인 결과이며 항상 성능이 오른다는 정리가 아니다.
Keeping Queries, Sharing Memory
32 Query heads를 8 KV groups에 연결하면 Query heads 4개가 같은 Key/Value head를 참조한다. 이 Queries가 같은 vector나 같은 weights를 갖는다는 뜻은 아니다. 서로 다른 Query가 공유된 Keys를 다르게 score할 수 있다. MQA는 이를 한 KV head까지 줄이는 더 강한 공유다.
GQA 원 논문은 처음부터 다른 모델을 학습한 비교가 아니라 MHA checkpoint의 group 안 K/V heads를 평균해 전환한 뒤 uptraining한 실험이다. Original steps의 5%만큼 continued pre-training한 결과, 소개된 평균 품질은 MHA에 가깝고 Decode는 MQA에 가까웠다. 이는 작은 품질 차이와 큰 KV 절감을 교환하는 특정 setting의 결과이지 GQA가 MHA보다 항상 더 정확하다는 주장은 아니다.
Multi-Head Latent Attention
DeepSeek-V2 MLA는 를 로 512d content latent 에 압축하고 별도 64d RoPE key를 cache한다. Inference에서는 up-projection을 Query 쪽, up-projection을 Output 쪽 projection에 흡수해 full content /를 materialize할 필요를 줄인다.
Why Projection Absorption Helps
작은 latent를 저장해 놓고 매 Decode step마다 과거 모든 tokens의 full K/V를 다시 펼치면 압축의 이득이 줄어든다. Content Key를 로 적으면 내적은 다음처럼 바꿀 수 있다.
과거 Keys를 모두 변환하는 대신 이번 Query 하나를 latent와 비교할 수 있는 방향으로 변환하는 것이다. 교수님의 비유로는 영어 편지 수만 통을 한국어로 번역하기보다 한국어 질문 하나를 영어로 바꾸어 비교하는 것과 같다. Value 쪽도 선형 up-projection을 weighted sum 뒤 output projection으로 흡수하여 full content K/V를 매번 materialize하는 부담을 줄인다.
그러나 RoPE rotation은 Key의 position마다 달라진다. 이 position-dependent 연산이 content projection 사이에 들어가면 하나의 고정된 Query-side projection으로 흡수하는 위 과정이 방해된다. 그래서 DeepSeek-V2는 512d content latent와 별도 64d decoupled RoPE key를 둔다. Cache에는 둘 다 들어가며 총 576 values/layer다.
원 architecture의 full K/V 32,768 → 576 values와 아래의 32-head 통일 chart는 서로 다른 비교 설정이다. Head 공유와 latent compression은 다른 축이며, numbers를 비교할 때 layers·head width·dtype·parallelism을 함께 맞추어야 한다.
Cache Comparison
동일한 32 layers / BF16 / 32 heads / width=128 가정의 token당 cache는 MHA 512KiB, GQA-8 128KiB, MLA-style 576 values/layer의 36KiB, MQA 16KiB다. 원 DeepSeek architecture의 비교와 동일 조건으로 만든 chart를 혼합하지 않는다.
Cache size, decoding speed, quality는 서로 다른 trade-off다. MLA에서는 content와 position을 분리하고 projection을 흡수한다. Cache chart의 숫자 암기보다 memory를 줄이는 구조가 중요하다.
Cache가 작다는 것, Decode가 빠르다는 것, 모델의 답이 정확하다는 것은 서로 다른 평가다.
MHA의 Attention intermediates와 KV Cache는 다르다. MLA의 cache 수치 비교에서 layers/headwidth/dtype가 같은지 확인한다.
Head 공유와 latent compression의 절감 축이 다르다.
MHA · GQA · MQA · MLA
Head 공유와 latent compression을 나누어 이해한다.
| Aspect | MHA | GQA-8 | MQA | MLA-style |
|---|---|---|---|---|
| Query heads (비교 설정) | 32 | 32 | 32 | 32 (통일 chart 가정) |
| Cache 형태 | 32 KV heads | 8 KV heads | 1 KV head | 512 latent + 64 RoPE values/layer |
| KiB/token · 32 layers BF16 | 512 | 128 | 16 | 36 |
| 줄이는 축 | Reference | 저장 representation 폭 | ||
| 주요 trade-off | 큰 KV state | MHA quality/MQA speed 근접 보고 | 최소 shared KV state | Compression / projection absorption / position 분리 |
위 수치는 32 layers,width128,BF16,no tensor parallel의 통일 chart다. 원 DeepSeek-V2의 32,768→576values 비교와 혼합하지 않는다.
Check
32 Query heads에서 MHA / GQA-8 / MQA의 KV heads와 cache 비율을 말하라.
Answer
KV heads는 각각 32 / 8 / 1이다. 동일 width·dtype·layers라면 cache 비율은 1 / / 1/32다. Query heads를 같이 줄이는 정의가 아니다.
MLA에서 RoPE key를 별도로 cache하는 이유는?
Answer
Position-dependent rotation이 Key up-projection을 Query 쪽으로 흡수하는 것을 방해한다. 따라서 content latent와 decoupled RoPE key를 분리한다.
GQA는 성능 향상을 위해 도입됐다는 설명에 어떤 보정이 필요한가?
Answer
강의는 주요 목적을 KV Cache memory 절감으로 설명한다. Quality 유지와 speed는 실험별 trade-off이며 향상을 보장하지 않는다.
GQA와 MLA는 KV Cache를 줄일 때 각각 무엇을 줄이는가?
Answer
GQA는 여러 Query heads가 K/V heads를 공유하여 cache의 KV head 수를 줄인다. MLA는 K/V 내용을 latent representation으로 압축하고, 위치 의존 RoPE Key를 분리한다. Query head 수 감소, KV head 공유, latent 압축은 같은 선택이 아니다.
여러 Query head의 group마다 / head를 공유하는 방법은?
Answer
Grouped Query Attention (GQA). Group 수만큼 KV heads가 남는다.
Full / 대신 content latent와 별도 positional key를 cache하는 DeepSeek-V2 방식은?
Answer
Multi-Head Latent Attention (MLA). Head 공유만 하는 GQA/MQA와 다르다.
MHA · GQA · MQA · MLA를 축별로 비교하고 그 차이가 필요한 이유를 설명하세요.
Answer
Head 공유와 latent compression을 나누어 이해한다.
Query heads (비교 설정): MHA=32 / GQA-8=32 / MQA=32 / MLA-style=32 (통일 chart 가정)
Cache 형태: MHA=32 KV heads / GQA-8=8 KV heads / MQA=1 KV head / MLA-style=512 latent + 64 RoPE values/layer
KiB/token · 32 layers BF16: MHA=512 / GQA-8=128 / MQA=16 / MLA-style=36
줄이는 축: MHA=Reference / GQA-8= / MQA= / MLA-style=저장 representation 폭
주요 trade-off: MHA=큰 KV state / GQA-8=MHA quality/MQA speed 근접 보고 / MQA=최소 shared KV state / MLA-style=Compression / projection absorption / position 분리
조건: 위 수치는 32 layers,width128,BF16,no tensor parallel의 통일 chart다.
원 DeepSeek-V2의 32,768→576values 비교와 혼합하지 않는다.