M3DocDep Chunking
문서를 일정 길이로 자르면 구현은 간단하지만, table과 caption이 다른 chunk로 떨어지거나 설명이 제목과 분리될 수 있다. 가까운 위치의 text가 항상 가장 관련 있는 정보도 아니다. M3DocDep은 문서의 blocks를 먼저 찾고, 그 blocks의 의존 관계를 따라 chunk를 구성하여 이런 맥락을 보존하려는 예시다.
- Document parsing / OCR
- Global blocks
- Frozen LVLM + SoftROI
- Biaffine scoring
- MST global tree
- Structure-aware chunks
Document Structure
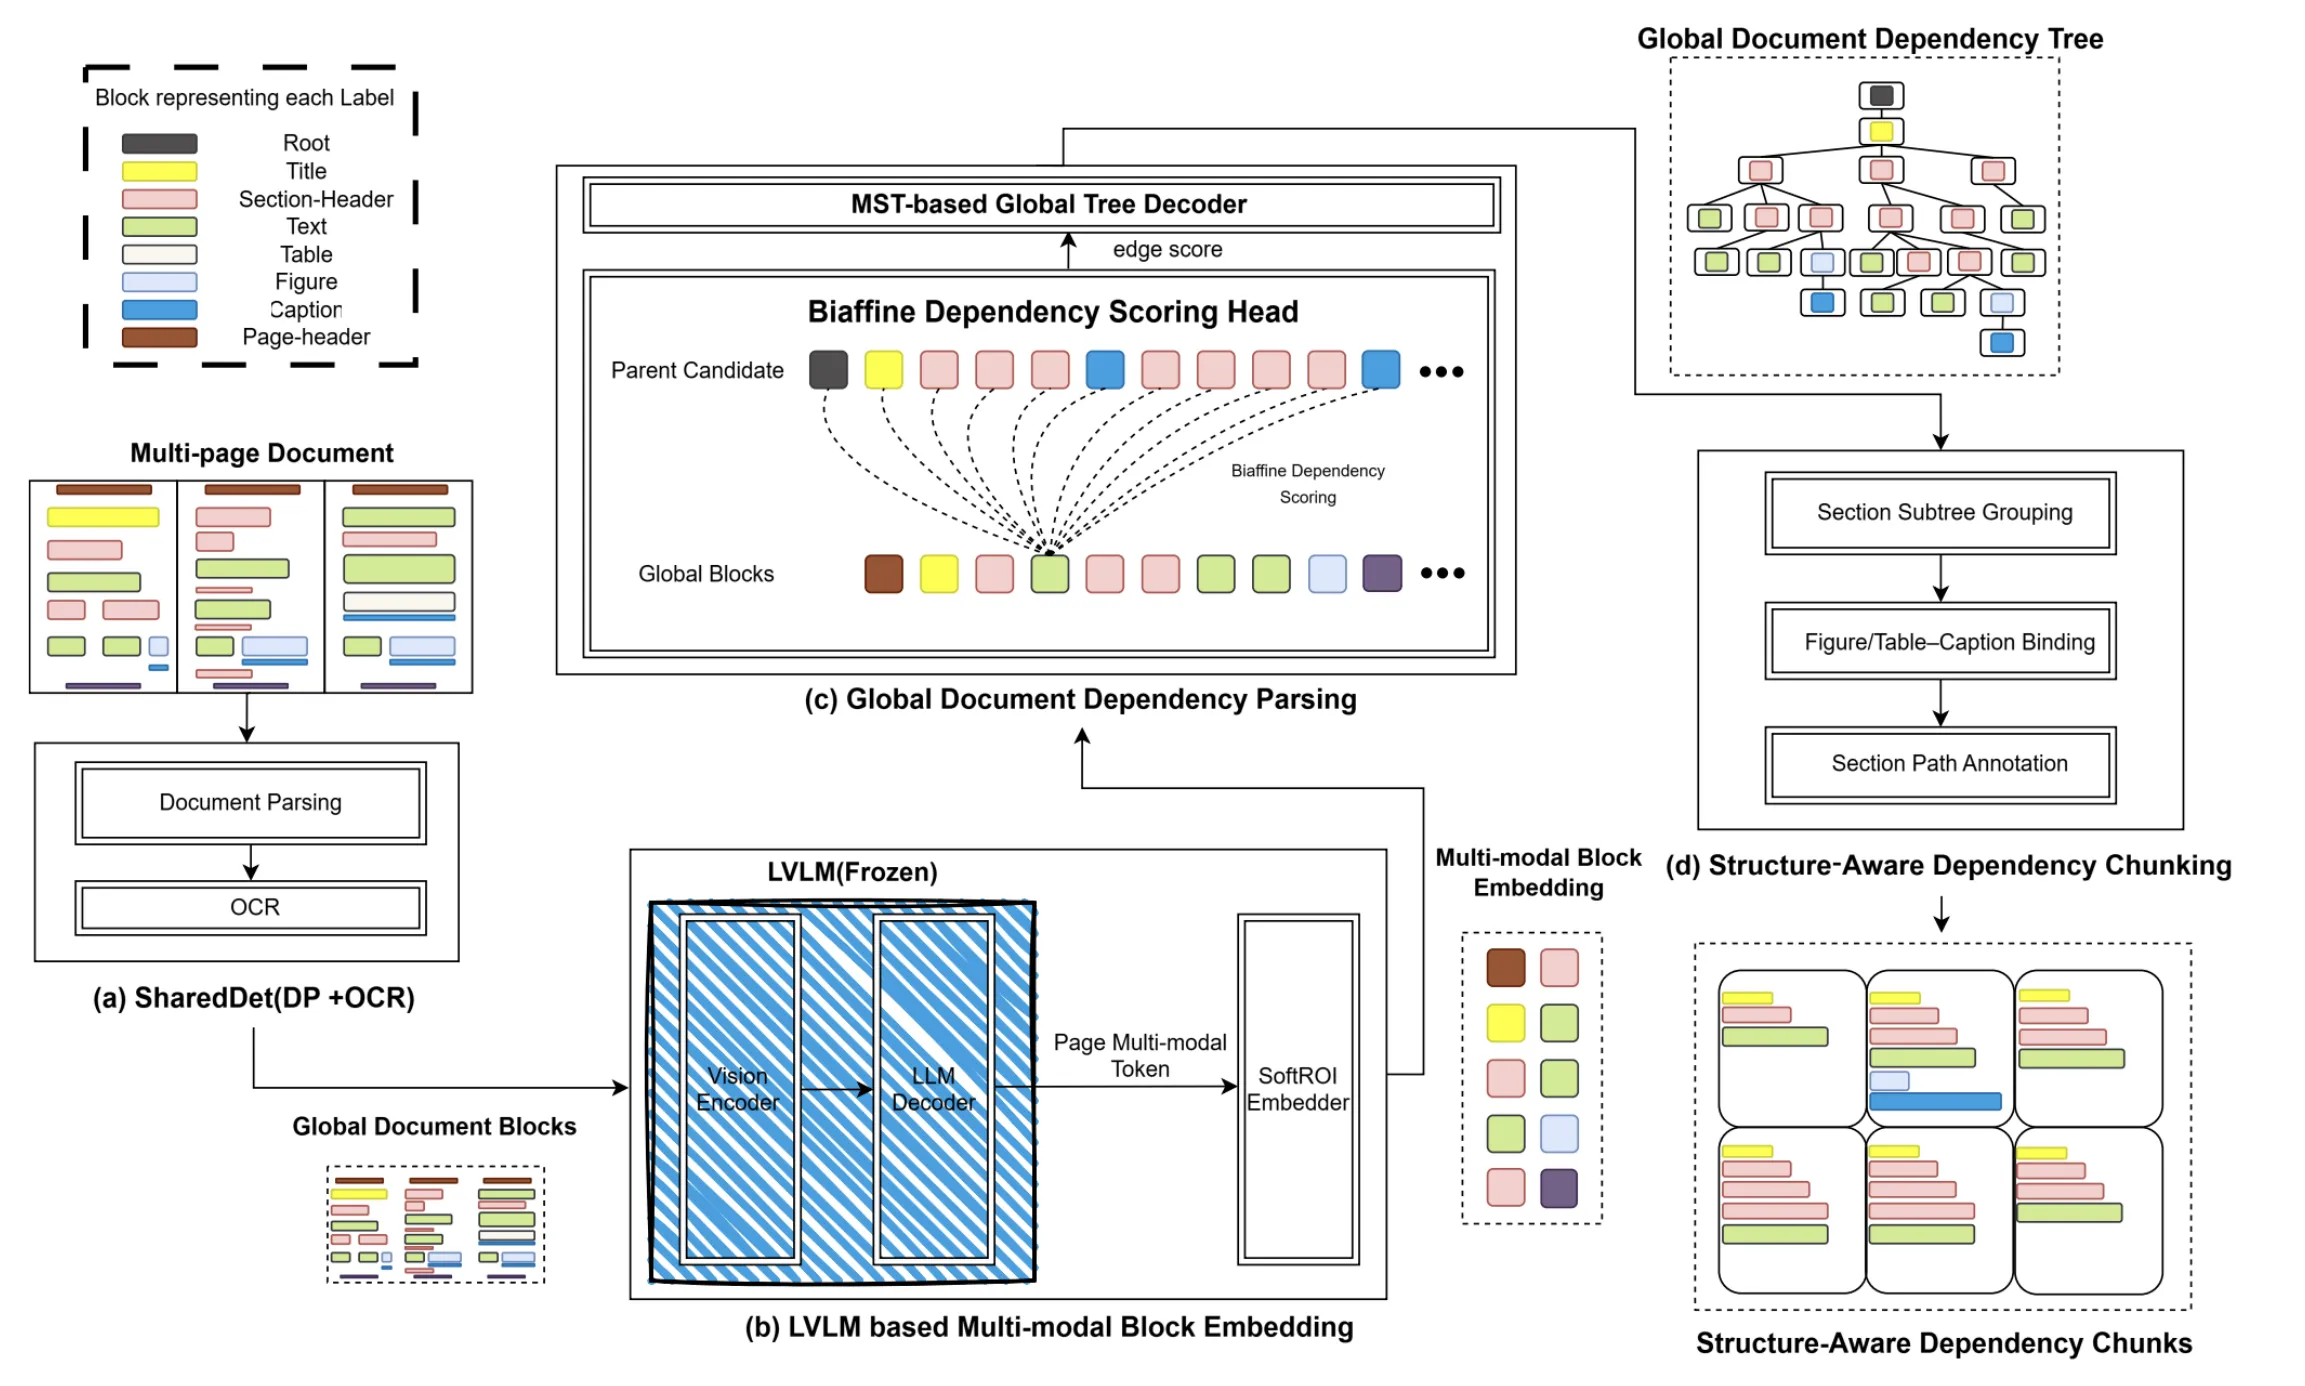
Figure의(a)SharedDet Document Parsing+OCR로 blocks를 모으고,(b)Frozen LVLM/Vision Encoder/LLM Decoder와 SoftROI가 multimodal block embedding을 만든다. (c)Parent candidates와 global blocks의 Biaffine Dependency Scoring Head→MST-based Global Tree Decoder로 관계를 잡는다. ()Section subtree grouping→Figure/Table/Caption binding→Section path annotation으로 chunk를 만든다.
From Blocks to Relations
Parsing과 OCR에서는 title, section header, text, table, figure, caption 등 문서의 blocks를 모은다. 그러나 blocks를 모았다는 사실만으로 “이 caption은 어느 figure를 설명하는가”라는 관계까지 알게 되는 것은 아니다. 페이지 이미지의 시각 정보와 언어 정보를 함께 표현한 뒤, SoftROI로 block 위치에 해당하는 features를 모아 각 block의 Embedding을 얻는다.
다음 단계에서 parent candidates와 child blocks 사이의 관계 점수를 Biaffine Head로 학습한다. Title이나 section header처럼 parent 역할에 적합한 후보를 고려하고, 전체 blocks를 대상으로 일관된 tree를 만든다. 교수님은 MST 기반 decoding을 순환 없이 모든 nodes를 연결하면서 총 관계 점수가 높은 tree를 고르는 과정으로 설명했다. 단순히 이름 때문에 최소 비용을 찾는다고 해석하면 이 강의의 방향을 놓친다.
Keeping Context Across Boundaries
관계는 같은 page 안에만 갇히지 않는다. Title → Section 1 → Subsection 1.1처럼 문서의 path를 알면, 길이 제한으로 중간에 잘려도 다음 chunk에 title과 section path를 함께 붙일 수 있다. Figure/Table/Caption binding도 관련 blocks가 떨어지지 않게 묶는 단계다.
이렇게 만든 chunk는 isolated text 조각보다 어느 문서의 어느 주제에 속한 정보인지 더 잘 보존한다. 여전히 length 제약은 존재하지만 자르는 기준을 구조와 연결한다는 점이 다르다. 교수님이 강조한 것은 특정 모델 이름을 외우는 것이 아니라, 검색 품질이 backbone 크기만이 아니라 무엇을 검색 단위로 구성했는지에도 크게 영향을 받는다는 사실이다.
해당 연구의 상세 방법은 시험에 내지 않는다고 안내되었다.
시험 비출제 발언은 이 연구 상세에 관한 설명이다. Retrieval이나 Chunking 전체가 시험 범위 밖이라는 뜻으로 확대하지 않는다.
Check
길이 500으로 자른 chunk가 문서 구조를 잃을 수 있는 두 경우는?
Answer
중간 설명이 잘리고 title/section 연결이 없어질 수 있다. 표·그림과 caption이 서로 다른 chunk에 떨어질 수도 있다.
구조 기반 Chunking에서 parent-child tree가 필요한 이유는?
Answer
멀리 떨어지거나 페이지를 넘는 관련 blocks를 계층화하고 section path와 caption 관계를 보존하기 위해서다.