MRL Evaluation
앞에서 본 MRL의 목적은 작은 prefix에서도 유용한 representation을 얻는 것이었다. 이제 그래프에서는 dimension을 줄일 때 품질이 얼마나 빠르게 떨어지는가를 읽는다. 같은 accuracy를 더 적은 coordinates로 얻을 수 있다면 저장과 similarity 계산에 유리한 operating point가 된다. 그래프의 결론을 이해하려면 curve뿐 아니라 가로축, metric, 비교 방법을 함께 보아야 한다.
- Representation Size 선택
- Top-1 / 1-NN 평가
- quality-cost operating point
Representation Size & Quality
MRL Evaluation은 nested-prefix 원리를 Top-1 Accuracy와 1-NN Accuracy vs Representation Size 그래프로 보강한다. MRL/MRL-는 작은 prefix에서도 강한 결과를 보이고 FF/SVD/Similarity Net/Random LP·FS 등의 곡선과 비교된다.
가로축 Representation Size는 8에서 2048까지의 dimension이며, 8 → 16 → 32처럼 배로 늘어나는 눈금이다. 첫 그래프의 Top-1 Accuracy와 둘째 그래프의 1-NN Accuracy는 서로 다른 평가이므로 같은 높이가 같은 의미는 아니다. 각 그래프 안에서 같은 dimension의 방법끼리 비교하거나, 목표 품질에 도달하는 최소 dimension을 비교해야 한다.
MRL과 MRL-E는 작은 dimension에서도 상대적으로 높은 값을 보이고, 여러 baselines는 dimension이 충분히 커져야 따라오는 경향을 보인다. 이는 nested-prefix 학습의 효과를 보여 주는 실험 결과다. 모든 cut point에서 품질이 똑같거나, 임의의 다른 model과 task에서도 같은 curve가 나온다는 정리는 아니다.
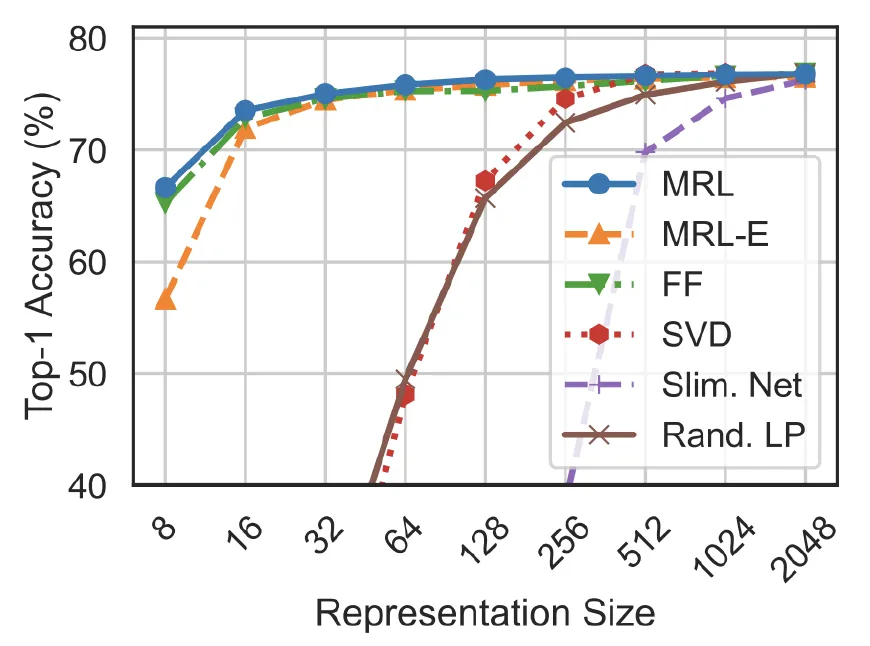
Top-1 Accuracy
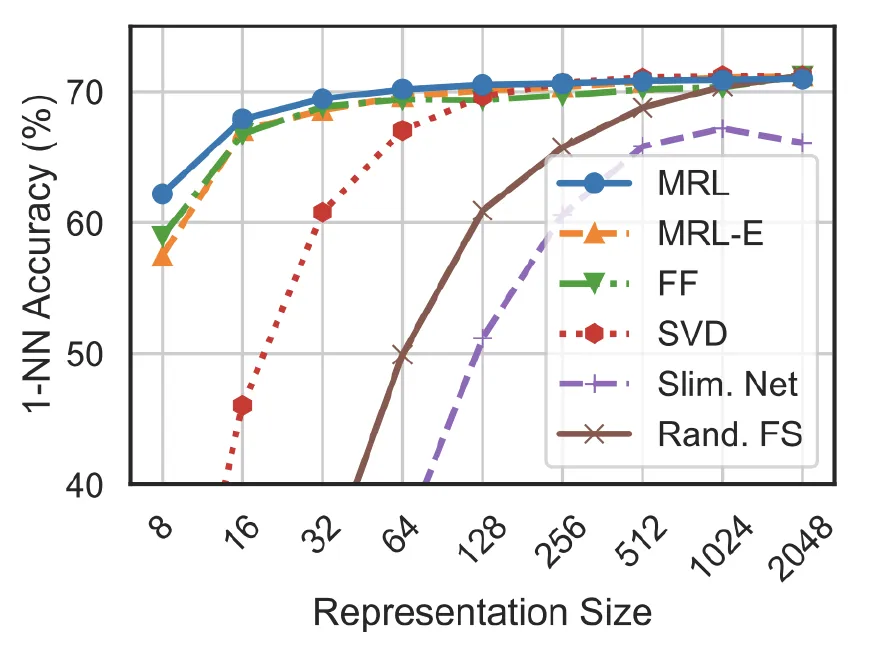
1-NN Accuracy
이 curve를 배포에 적용할 때는 자신의 task에서 선택한 prefix의 품질을 확인해야 한다. Slice 뒤 re-normalization과 해당 dimension의 ANN index도 필요하다. Encoder forward는 여전히 full vector를 만들 수 있으므로, graph의 작은 representation size를 encoder 자체가 그만큼 가벼워졌다는 뜻으로 읽지 않는다.
Check
그래프에서 representation size를 줄여도 품질이 유지되는 결과를 어떤 설계 선택에 이용할 수 있는가?
Answer
해당 model/task에서 검증한 prefix를 골라 저장·검색 비용을 줄이는 operating point로 쓴다.
Top-1과 1-NN 곡선이 있다는 이유로 모든 task에서 같은 dimension을 쓰면 되는가?
Answer
아니다. metric과 평가 setting이 다르고 model·task별 검증이 필요하다.