Positional Information
“dog bites man”과 “man bites dog”는 같은 단어를 쓰지만 뜻이 다르다. 그런데 position signal이나 position-dependent mask가 없는 Self-Attention은 단어의 위치를 바꾸면 계산 결과도 같은 방식으로 재배열할 뿐이다. 따라서 내용 사이의 관계에 어순의 차이가 반영되게 하는 신호가 필요하다. Sinusoidal은 Embedding에 위치 vector를 더하고, RoPE는 Q/K의 회전을 통해 Attention score에 위치를 반영한다.
- 위치 m,
- /의 2D pair 회전
- dot product
- 상대 offset −m 반영
Permutation Equivariance
Position signal이나 position-dependent mask가 없으면 일 때 , 다. 입력을 섞으면 출력도 같은 순서로 섞이는 permutation-equivariant이며 invariant가 아니다.
Position-Dependent Connectivity
여기서 symmetry는 “출력이 아예 같다”는 뜻이 아니다. 예를 들어 원래 dog row가 man을 읽던 비중은 입력을 섞은 뒤에도 dog–man 쌍을 따라 이동한다. 행과 열이 함께 바뀌므로 이고, output rows도 같은 로 재배열된다. 이것이 permutation-equivariance이며, 출력이 변하지 않는 permutation-invariance와 다르다.
슬라이드의 예시를 matrix로 쓰면 첫째와 셋째 positions를 바꿀 때 다음과 같이 대응한다.
Causal Mask를 적용하면 position마다 접근 가능한 Key의 범위가 달라진다. 첫 position은 자기 자신만, 둘째는 첫째와 자기 자신을, 셋째는 앞의 세 positions를 읽는다. 같은 token을 첫째에서 셋째로 옮기면 그 token이 읽을 수 있는 내용 자체가 달라진다. Mask가 고정한 왼쪽→오른쪽 connectivity를 유지하는 한, 입력을 임의로 섞어도 단순히 기존 결과를 따라 재배열하는 위 관계는 일반적으로 성립하지 않는다.
RNN에서는 로 직전 state를 거쳐야 하므로 순서가 recurrence 안에 이미 들어 있다. 반면 Self-Attention의 모든 position을 함께 계산하는 구조에는 이 의존성이 내장되지 않는다. Position signal과 mask가 어떤 역할을 더하는지 나누어 이해해야 한다.
Sinusoidal Encoding
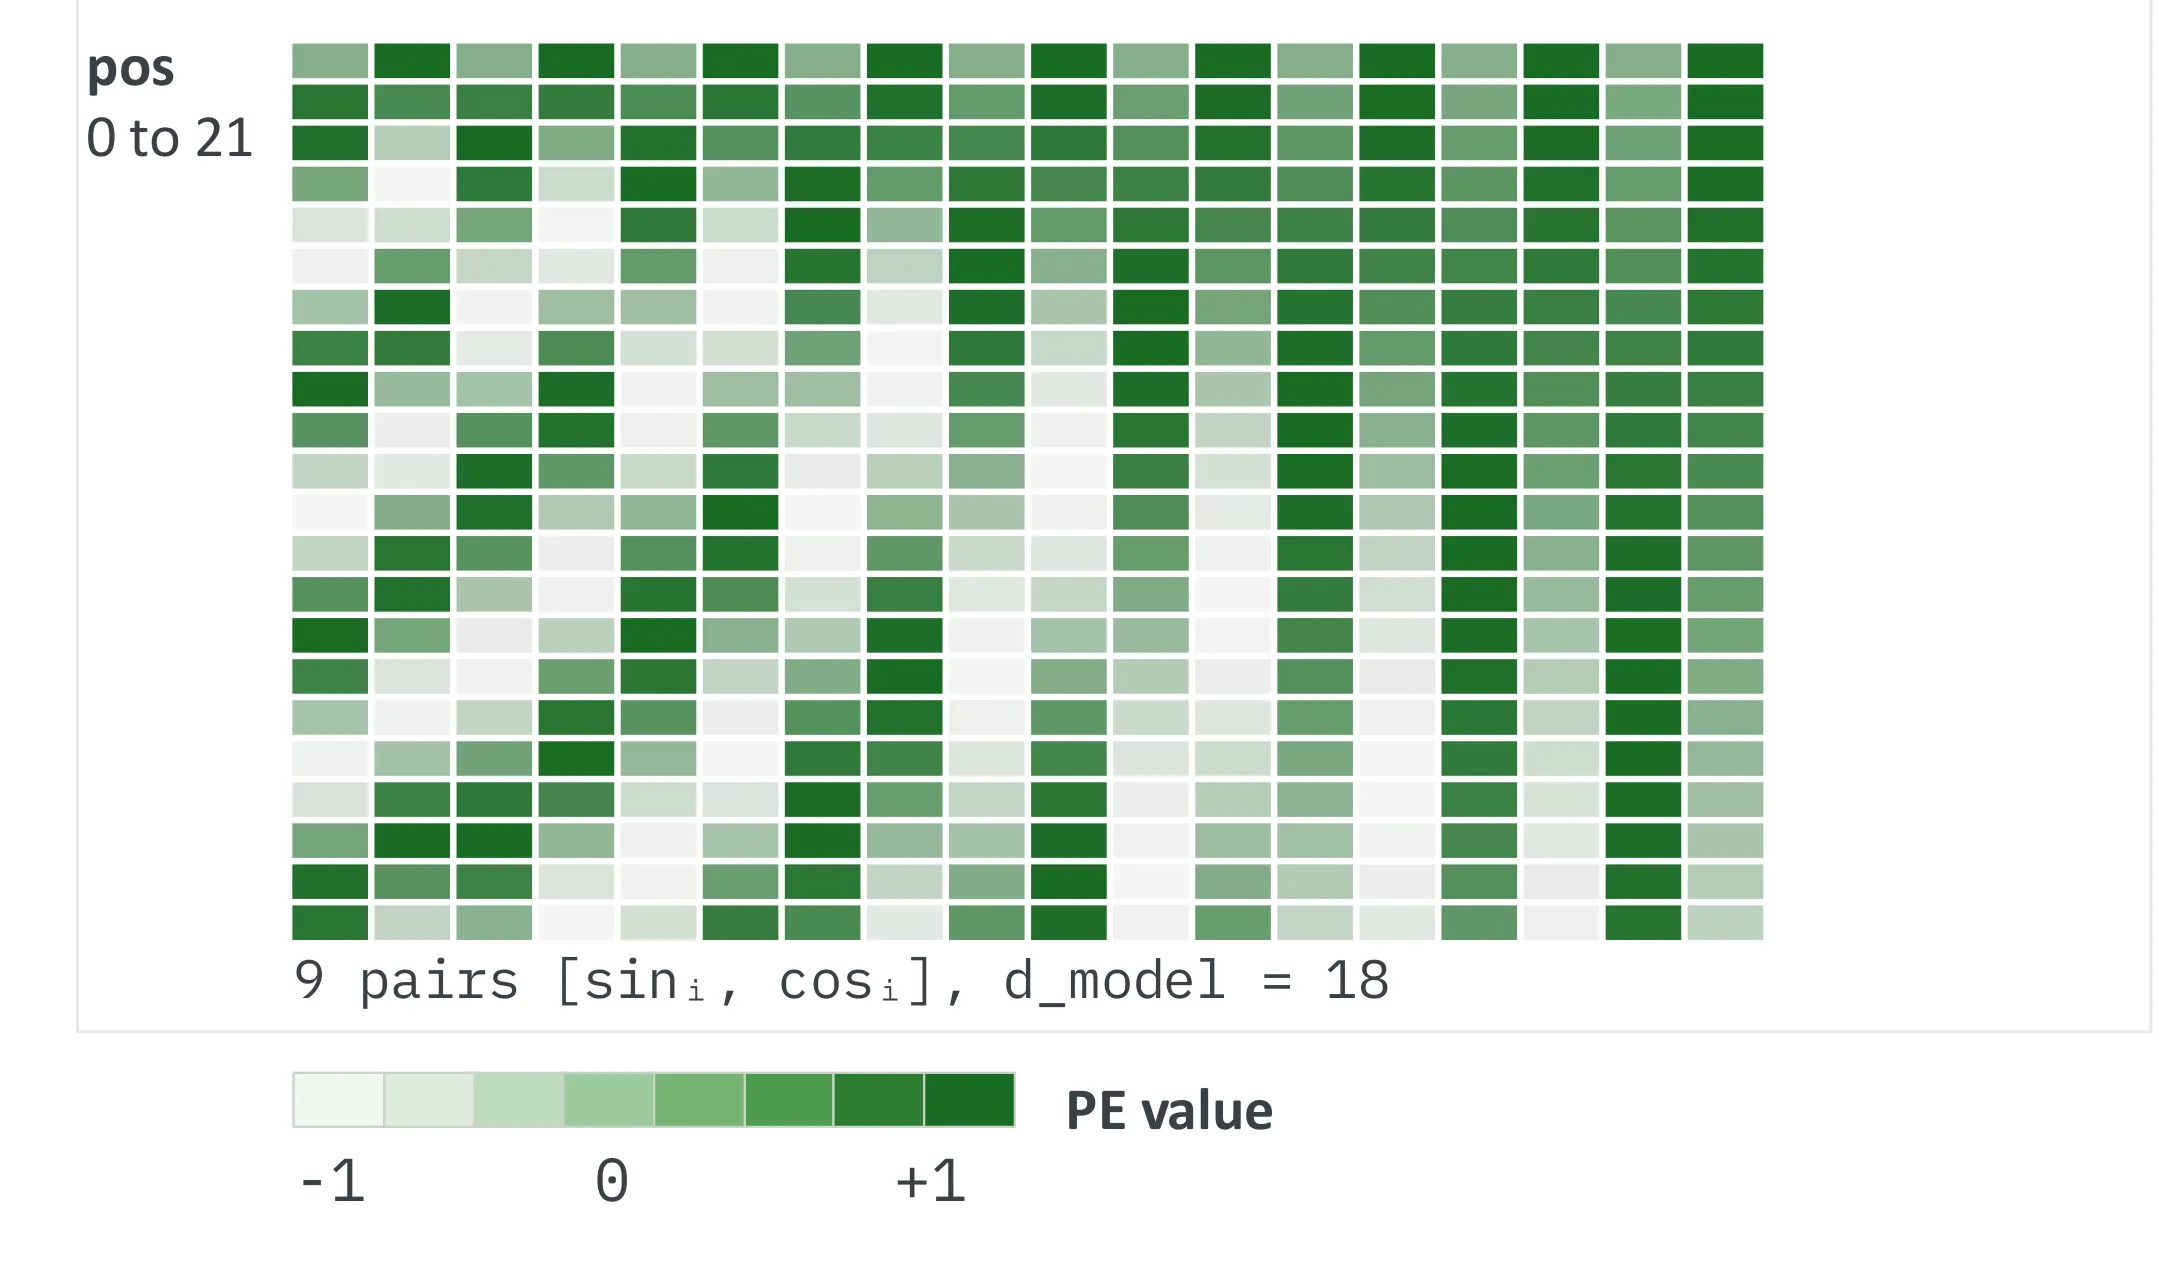
Sinusoidal은 token embedding에 같은 width의 position vector를 더한다. 각 dimension pair의 sin/cos가 의 서로 다른 주파수를 갖는다. 같은 위치 shift는 pair마다 같은 2D rotation이다. d18이면 9pairs다.
Learned position embedding은 위치별 vector를 저장한다. Sinusoidal의 미관측 index 계산 가능성이 긴 context 품질을 보장하지 않는다.
Sinusoidal의 각 pair는 서로 다른 속도로 도는 시계에 비유할 수 있다. 이면 9 pairs이고, 각 position은 같은 9개 frequencies를 공유한다. Position마다 frequency를 새로 바꾸는 것이 아니라, position이 증가하면서 각 pair의 phase가 변한다. 앞 pairs는 빠르게 돌고 뒤 pairs는 느리게 도는 것은 가 에 따라 기하급수적으로 작아지기 때문이다.
Position 3 → 5와 100 → 102는 시작점은 다르지만 같은 offset 2이므로 pair마다 의 같은 회전에 대응한다. 수식으로 unseen index의 값을 계산할 수 있어도, 모델이 그 joint phases를 학습했는지는 별개다. 특히 느린 frequency가 training 구간에서 한 주기도 다 보지 못했다면 긴 구간에서 미관측 표현을 받을 수 있다.
Rotary Position Embedding
RoPE는 ,의 각 2D pair를 절대 위치 만큼 회전한다. 내적은 으로 정리돼 상대 offset이 반영된다.
는 Attention score 계산에 개입하지 않아 회전 대상이 아니다. Head 일부 차원만 rotate하는 구현도 있다. 공통 shift가 이 positional term에서 상쇄되어도 full model의 causal mask/경계 영향은 남는다.
각 coordinate pair의 회전은 다음 matrix로 표현할 수 있다. 는 해당 pair에 적용할 각도다.
Position 의 Query에는 , position 의 Key에는 를 적용한다. 내적할 때 Query 쪽 회전이 transpose되어 반대 방향이 되므로 두 회전의 차이만 남는다.
과 은 모두 offset 3이므로 같은 positional term을 갖는다. 하지만 과 의 content는 여전히 식에 남아 있다. 상대 위치만으로 score를 정한다는 뜻은 아니다. 또한 full model에는 Causal Mask와 sequence boundary의 영향도 남는다.
회전하는 대상이 Q/K인 이유는 Attention score를 만드는 내적에 이 둘이 참여하기 때문이다. V는 이미 계산한 weights로 섞을 내용이므로 이 RoPE 계산의 회전 대상이 아니다. RoPE를 Token Embedding에 position vector를 더하는 방식으로 그리거나, 정해진 를 별도 learned projection으로 설명하면 안 된다.
Check
Position signal과 mask가 없는 Self-Attention은 permutation-invariant인가?
Answer
아니다. Input permutation에 따라 output도 같은 permutation으로 바뀌는 equivariant다. Causal mask는 위치 의존 구조로 이 대칭을 깬다.
RoPE는 absolute rotation을 하면서 어떻게 relative score를 얻는가?
Answer
R(m)ᵀR()=R((−m))로 정리돼 dot product에 상대 offset이 들어간다. 를 회전하는 과정이 아니다.
같은 token을 첫째 position에서 셋째로 옮기면 Causal Mask 아래에서 무엇이 달라지는가?
Answer
첫째 position은 자기 자신만 읽지만 셋째는 앞의 세 positions를 읽을 수 있다. Token 내용이 같아도 접근 가능한 Key의 집합이 달라지므로 position-dependent connectivity가 생긴다. RNN은 직전 state를 거치는 recurrence 자체에 이 순서 의존성을 담는다.
Absolute position으로 / 2D pairs를 돌려 dot product에 relative offset을 만드는 방식은?
Answer
Rotary Position Embedding (RoPE). 를 회전하지 않는다.
Sinusoidal · RoPE · ALiBi · NoPE를 축별로 비교하고 그 차이가 필요한 이유를 설명하세요.
Answer
Position signal을 넣는 위치와 방식이 다르다.
적용: Sinusoidal=Embedding에 vector 더함 / RoPE=/ 2D pairs 회전 / ALiBi=Score에 distance penalty / NoPE=Explicit encoding 없음
신호: Sinusoidal=여러 sin/cos frequencies / RoPE=Dot product의 relative rotation / ALiBi=Head별 fixed slope / NoPE=Causal prefix / BOS anchor
영향: Sinusoidal=입력 state에 더함 / RoPE=는 회전하지 않음 / ALiBi=를 직접 바꾸지 않음 / NoPE=Implicit signal 활용
긴 길이: Sinusoidal=계산 가능 ≠ 품질 보장 / RoPE=Joint phase OOD 가능 / ALiBi=정의 가능 ≠ 품질 보장 / NoPE=Setting별 평가 필요
조건: Positional encoding과 local/global Attention span은 독립적인 설계 축이다.